【ChatGPT Plus】ChatGPTのWorkspace ID / Account IDを確認する方法

コンテキスト / 解決したい問題

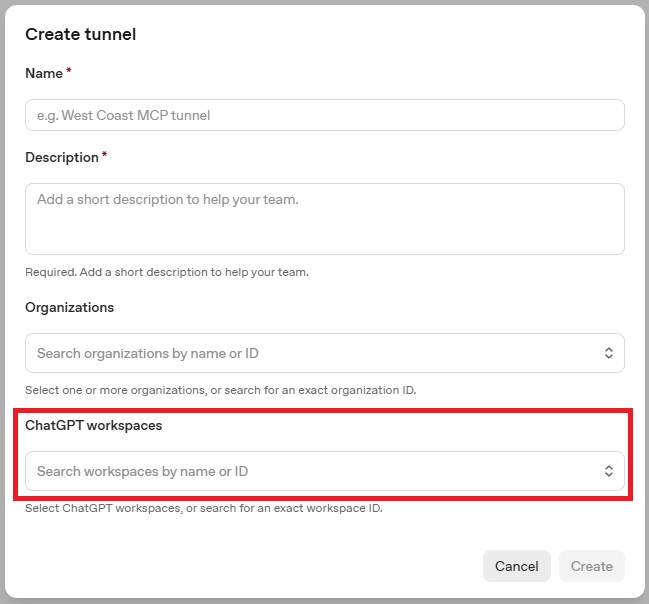
Secure MCP Tunnelの作成画面にて、ChatGPT Workspaceの入力画面を求められる。

→ 該当フィールドはプルダウンになっており、選択可能なWorkspace IDが初期状態で表示されている。

→ が、そのWorkspace IDが自分のChatGPT Plusの契約と合致するかわからない。

→ ChatGPT Plusの契約が持つWorkspace IDを確認したい。

解決策

Google Chromeの開発者ツールで確認することができる。

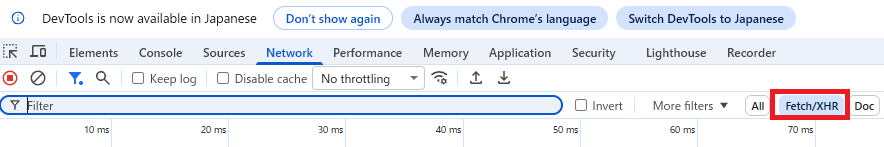
(1) Google ChromeのDevelper Toolを起動 → Networkを選択し、Fetch/XHRを選択する

(2) その状態でChatGPTのトップページを開く

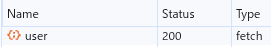
(3) ↓のようにUserに対しFectchが実行されるので、クリックして詳細画面を開く

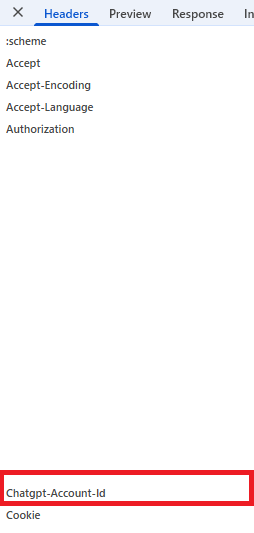
(4) Request Headersの中に以下のように、ChatGPT-Account-Idが表示される。あとは、このID値(UUID)がSecure MCP Tunnelの作成画面に表示される値と合致することを確認すればOK。

疑問点・学び

  • どうやら、 ChatGPT-Account-Id === Workspace ID ということみたい
  • WebGUIから確認する方法は何らかあるのか?

ubuntuにgitの最新バージョンを入れたい

コンテキスト / 解決したい問題

  • Ubuntu 24 LTSにて、Ubuntu公式のaptリポジトリだとgitのバージョンが古く新しめの機能が使えない

解決策

  • Ubuntu Git Maitainers が提供のPPAリポジトリを使うと新しめのバージョンの git(1) が apt でインストールできるようになる

実行例

$ sudo add-apt-repository ppa:git-core/ppa -y
$ sudo apt update -y
$ sudo apt upgrade -y

historyに履歴を残さずに認証情報を環境変数に格納したい

状況

IDやPWなどの認証情報を直接CLIコマンドに渡して動作確認をしたい。 しかしながら、 history(1) に履歴を残したくない。

解決策

read(1) + s オプション (入力文字を画面に表示しない) を使うことで、historyに履歴を残すことなく環境変数に値を渡すことができる。

bashの場合

read -sp "Password: " PASSWORD; echo

※bashの場合 -p : promptを表示する をつけないと bash: read:Password: ': not a valid identifier` エラーとなる。

zshの場合

read -s "PASSWORD?PASSWORD: "; echo

※zshの場合 -p をつけると read: -p: no coprocess エラーとなる。これはreadがシェルの組み込み関数でbashとzshで挙動が違うから。具体的には、zsh版の read(1) では -p は「coprocess から入力を読む」という意味になる。

環境変数に追加したい

上記で登録されるのはシェル変数であって、環境変数ではない*1ので env(1) の実行結果には出てこない。環境変数としても登録したい場合は再度 export(1) を実行する必要がある。

$ export PASSWORD=$PASSWORD

LLMに文章を書いてもらうと読者のmental modelに対する配慮が抜け落ちがちなのかもしれない

ChatGPTに自分用の週次レポートを書いてもらっている時に、文章について以下のように指摘した。

癖がわかってきた。 まず以下だけど

>UberのLarge-Scale Automated 依存関係 Analysisは、   
>複雑なマイクロサービスメッシュで直接・間接依存を
>継続的に把握し、失敗 impactを評価する仕組みを説明している。 

読者の頭の中に「UberのLarge-Scale Automated 依存関係 Analysis」という語彙がなく、 
それがなんであるかmental modelがないのに、
さも、それが読者にとって既知であるかのように 説明が始まっており読者を置いてきぼりにしている文章になってしまっている。

以下もそう   

>Datadogの9月15日の記事は、エージェント導入の議論を
>「モデル・プロンプト・ツール」から「基盤処理能力」へ引き戻す点で重要である。 

とあるが、同様に読者はその記事がどのようなものであるかを知らない。 

だから本当は「Datadogの9月15日の記事 - [タイトル名]において[著者名]は[topic」について論じた。彼の主張の骨子はxxxである」みたいに書く必要がある。 
 
全体的に「読者が何を知っていて何を知らないのか」に対する配慮が欠如している。

すると、以下のような返信があり大幅に文章の品質が改善された気がする。(主観)

その指摘で合っています。問題は単なる「日本語の自然さ」ではなく、文章設計上の前提が間違っていました。

前回の文章は、書き手側ではすでに調査を終えているため、「Large-Scale Automated Dependency Analysis」「Datadogの9月15日の記事」といった対象が頭の中に存在しています。その状態のまま書いているので、読者にも同じ文脈があるかのように扱ってしまっています。いわば、書き手の知識状態を読者に誤って投影しています。

文章論的には、これは「新情報を既知情報として提示している」問題です。読者の頭の中にまだ discourse referent が作られていないのに、その対象について評価や解釈を始めている。結果として、文法的には読めても、頭の中に像が立ち上がりません。

たとえばUberの箇所なら、先に対象を生成する必要があります。

Uber Engineeringは9月15日、「Large-Scale Automated Dependency Analysis at Uber」という記事を公開した。この記事では、数千規模のマイクロサービスが相互に呼び出し合うUberの環境で、「あるサービスに障害が起きたとき、どのサービスまで影響が波及するのか」を自動的に把握する仕組みを説明している。

マイクロサービスでは、サービスAがBを呼び、BがCを呼ぶ、といった間接依存が積み重なる。そのため、単純なサービス一覧だけでは障害影響を判断できない。Uberは実際の通信関係から依存グラフを継続的に構築し、直接依存だけでなく、その先の間接依存まで分析対象にしている。

この仕組みがAIOpsの観点で興味深いのは、LLMに障害原因を推測させる前に、「何が何に依存しているのか」という機械可読な構造を整備している点である。

これなら読者は、

「Uberの記事」
→「何の記事なのか」
→「どんな問題を扱うのか」
→「どう解いているのか」
→「なぜ今回取り上げるのか」

という順番でmental modelを組み立てられます。

またプロンプトが以下のように修正された。

【最重要:読者のmental modelを先に構築する】
読者はAWS、Datadog、Terraform、Claude Codeなど主要プロダクトの存在は知っている一方、その週に公開された個々の記事名、機能名、研究名、固有の概念、社内プロジェクト名については知らないものとして書いてください。書き手が調査済みであることを読者の既知知識と取り違えないでください。

新しい記事・機能・概念・固有名詞を初めて出す段落では、原則として次の順序で説明してください。
1. 誰が、いつ、何という記事・機能・発表を公開したか。
2. それが何を扱うものか。読者が頭の中に対象を作れるよう、1〜3文で素朴に説明する。
3. どのような問題を背景にしているか。必要なら既存方式や従来の前提を説明する。
4. その記事・発表の中心的な主張、仕組み、観測結果は何か。
5. その後で初めて『なぜ重要か』『SRE/Platform Engineeringにどう効くか』『AIOpsとどうつながるか』という評価・解釈を書く。

評価や含意から書き始めないでください。例えば『Datadogの9月15日の記事は重要である』ではなく、『Datadogは9月15日、○○という記事を公開した。この記事は△△を扱っている。そこで著者は□□と主張している。その上で、この発表が重要なのは…』のように、読者に対象を導入してから評価してください。

記事タイトルや固有名詞だけを主語にして説明を開始しないでください。『UberのLarge-Scale Automated Dependency Analysisは〜』のような書き出しは避け、まずその語が何であるかを導入してください。英語タイトルは必要に応じて原題を示してよいですが、日本語の説明を先に置き、原題は補助情報として扱ってください。

各段落を書く前に、『この段落の冒頭時点で読者は何を知っているか』『ここで初めて出す語は何か』『その語を理解するために不足している前提は何か』を内部的に確認してください。初出の対象を未定義のまま『この仕組み』『このアプローチ』『この問題』と指示語で受けないでください。指示語は、直前で対象が十分に説明されている場合だけ使ってください。

文章は『事実の提示 → 背景・構造の説明 → 仕組みや主張 → 含意・評価』の順に積み上げ、読者が順読みするだけでmental modelを再構成できるようにしてください。要約の圧縮率を上げるために前提説明を削りすぎないでください。短くする必要がある場合でも、固有名詞の導入と因果関係の中間過程は省略しないでください。

改善前と改善後の文章を比較すると以下となる。自分の感覚では修正後の方が読みやすい。

※注意:内容の技術的な正確性については未検証です。

改善前

Claude Code Projectsの9月17日の再設計では、複数エージェントの起動より、その後の調整を製品側が
担うようになった点が大きい。複数ターミナルやworktreeを使って人間が並列にタスクを進めること
は以前から可能だった。製品側は、タスクの対象範囲を決め、作業単位へ分け、各セッションへ委譲す
る。実行中の軌道修正、出力レビュー、最終統合まで同じ実行基盤が扱う。

。たとえば「checkoutのp75レイテンシを下げる」という目標を与えたとき、エ
ンドポイントごとのプロファイルや最適化を複数スレッドに分け、各スレッドで実験し、PRを生成し、
最終的な結果をまとめるという流れを製品側が組み立てる。
つまり、IDEに小規模な分散ジョブスケジューラとワークフローエンジンが組み込まれた。

改善後

Anthropicは9月17日、Claude Code向けの「Projectsの再設計 - フォルダーから会話へ」を公開した。ここ
でいうProjectsは、ひとつの開発目標に関係する複数のClaude Codeセッションをまとめて扱う機能で
ある。従来は人間が作業を分け、別々のセッションへ依頼し、その結果を最後に統合する必要があった。

新しいProjectsでは、利用者が「checkoutのp75レイテンシを下げる」といった目標を与えると、Claude
が対象範囲を整理し、エンドポイントごとの調査や最適化を複数のスレッドへ分けて実行する。各スレッ
ドは独立したクラウドセッションとして動き、途中で利用者が方向を修正できる。

ここから何が学べるのか?だけど、

  • 適切に問題点を指摘することで、文章品質が改善できた。これは大きい。one-shotまたはfew-shotで良い文例、悪い文例ともう少し改善できるかも。
  • この手の「解説文を書くときの定番の読みやすい言い回し」のようなものは一定パターンがあるので、そういうパターンをレゴブロックのように組み合わせて「型にはめる」アプローチの方が再現性高く読みやすい文章が作れるのかもしれない
  • 文章の品質をllm-as-a-judgeするときの観点として、ここで指摘したような読書のmental modelを適切に構築できているか?はありなのかもしれない

あと、LLMが作った文中にある discourse-referent という概念は初見だが興味深い。ちょっと掘り下げて調べてみたくなった。

なんにせよ、LLMに一定品質の文章を作らせることができると毎週の情報収集がはかどるのでもう少し試行錯誤してみたい。


追記:

もう一つ別のテクニックをプロンプトに盛り込んでみた。これは『まったく新しいアカデミックライティングの教科書』で学んだTIPSだ。 これはこれでworkするのか暫く観察したい。

me

あと、細かいテクニックだけど

>執筆者はDeepanshu Mehndiratta氏、Alok Srivastava氏、 Shivam Jindal氏である。 

みたいな文章は  

>執筆者はUberでリードアーキテクトを務めるDeepanshu Mehndiratta氏、ソリューションアーキテクト
のAlok Srivastava氏、QAアナリストのShivam Jindal氏である。 

などのようにセンテンスに付加情報を追加することで1つの文章の密度を上げてほしい。

AI

今回追加した観点は、「1文あたりの情報密度を高める」です。人物名だけで終わらせず、確認できる範囲で所属、役職、専門領域、担当範囲などを同じ文に自然に織り込むようにしました。

人物以外にも同じルールを適用します。たとえば単に「AgentCore」と書くのではなく、初出時には「AWSがBedrock上で提供するエージェント実行基盤AgentCore」のように、その対象の位置づけまで一文で分かる形にします。

一方で、情報密度を上げるために推測を混ぜないよう、「役職や所属は一次情報または信頼できる出典で確認できる場合だけ付加する」「一文には主張の核1つ+補足1〜2個程度」という制約も入れています。
Windows Control Panel File(cpl) とは何か

Windows11のトラブルシュートをChatGPTとしていた際に、 sysdm.cpl というファイルを実行する場面があった。

で「ところで拡張子 cpl」ってなんだっけ?となったので、少し調べたがざっくりとは、Windowsのコントロールパネルの操作インターフェースとして機能するプログラム群 と言う理解で良さそうだった。

https://youtu.be/d_Eng_HotZQ?si=CdA9jwqpIhDB0qbp

「cplを直接実行すると嬉しいことは何か?」と言う視点で見ると、 Windowsの複雑怪奇なGUI操作の遷移を覚えずとも、必要な設定項目を変えられるようになる ってところが良いところなのだろうか。

https://www.reddit.com/r/sysadmin/comments/xf2yji/run_sysdmcpl_bypasses_new_windows_1011_settings/?show=original

なんにせよ、トリビアとして覚えておく。

opencodeの主力モデルをGLM 5.2に切り替えた。

今年の1月に契約のGLM Light Planで GLM 5.2 が使える用になったので、モデルを切り替えてみた。

Grok曰く、ベンチマーク的には現在メイン利用の gpt-5.4-mini よりパフォーマンスに優れるとのことなので、活躍に期待したい。

cat ~/.config/opencode/opencode.json
{
  "$schema": "https://opencode.ai/config.json",
  "plugin": [
    "oh-my-opencode@3.11.1"
  ],
  "model": "zai-coding-plan/glm-5.2"
}

20260701

Docker Seandbox

というプロダクトが2026年2月頃に発表されていたのを今更知った。

https://docs.docker.com/ai/sandboxes/

内部的には、Micro VM用のVMMを自作して使っているらしい。FirecrackerはmacやWindowsの上で動作することを想定してないプロダクトなので不採用としたとのこと。

https://www.docker.com/blog/why-microvms-the-architecture-behind-docker-sandboxes/

VMとMicro VMの違いはなんぞ?とかMicro VMという選択肢の優位性は?というあたりが気になる。けど、そのあたりは昔書いたFirecrackerの記事をベースに理解しておけば良さそう。選択肢としてWASMが増えたけどそれ以外はそこまで問題空間が変わっていないように見える。

https://blog-smatsuzaki.hatenablog.com/entry/2020/11/29/132038

Coding Agentをサンドボックスの上で動かしたいとしてComputeはコンテナがいいのか?Micro VMがいいのか? が一つの論点に思う。セキュリティ面で見るとisolationはMicro VMの方が得意だ。反面、軽量さ/省リソース性という観点で考えるとMicro VMはContainerよりもずっと重い。host machineとは別にkernelを起動するのだから。なので、起動の速さも当然遅くなる。そこのあたりをどう考えるのか?だろうか。

herdr.dev を使い始めた

友人がcmuxを使っているのを見て羨ましがっていたら、herder.devがでできた。 これならWSL2でも動く!とのことでとりいそぎインストール。

しばらく使ってみる。

https://github.com/ogulcancelik/herdr

https://zenn.dev/dragon1208/articles/45708cc45a7a7c

セグメンテーションとは何か、何を目的にしているのか

PCI DSSに興味を持ち、ネットワークセグメンテーション、マイクロセグメンテーションなどの概念を復習する中で「そもそもセグメンテーションってどういう概念だっけ?」となって考えたことのメモ。

segmentとは「境界により隔てられている」みたいなニュアンス

まず、 セグメント(segment) という言葉の意味合いから。Oxford Learner's Dictionariesで segment の意味を引くと以下と説明されている。

a part of something that is separate from the other parts or can be considered separately

これを踏まえると、言葉の含意は以下となる。

  • (全体から)ある1部分/要素が切り出されている
  • 「あるsegment」と「他のsegment」はseparateされている / 境界により隔てられている

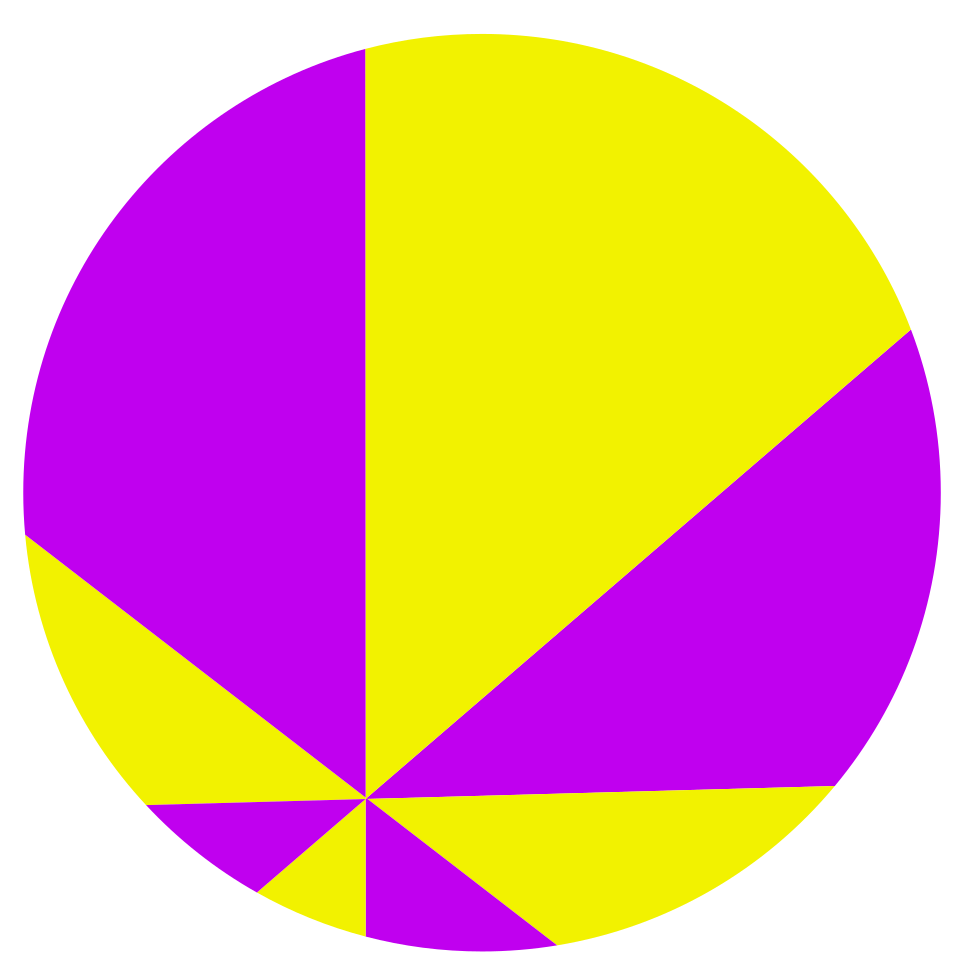
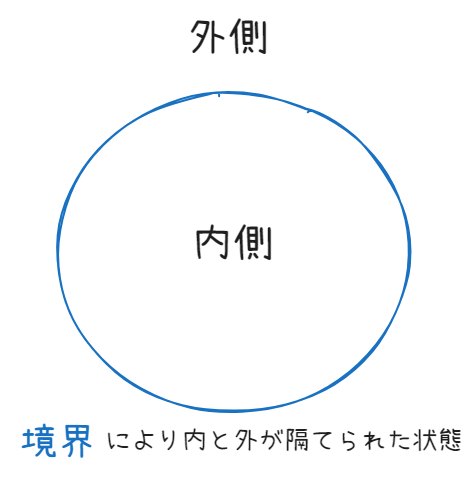
具象的なイメージは以下のようになるか。

  • 全体(円)が認識できる
  • 部分(色で塗分けされた部分)が認識できる
  • 部分と部分の間に明確な境界線が認識できる

画像の出典

「境界により隔てられている」ことがセキュリティ上なぜ大事なのか

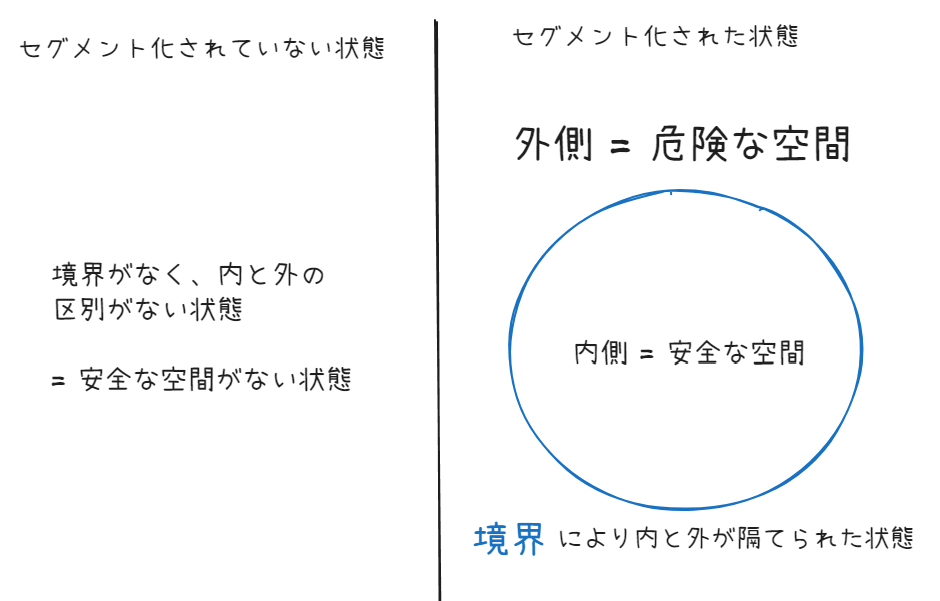
分けること = 守ることだから。より詳細には、境界によって外部と内部を分け、外部から内部への侵入を難しくすることで内部の安全性が向上するから。

「外側」には「攻撃」をしかけてくる「脅威」がいる。それに対して「安全」を確保するためには、「境界(壁)」を作り「脅威」が「内側」に入ってこない状態を作る必要がある。

つまり、「安全」を確保するための手段として「境界(壁)」がある。

※ 危険な存在が入ってこれない空間の確立 = 安全の確保、という発想 ※なので、「境界を作ることで、脅威をもたらす外敵が入ってくることのできない安全な空間(内側)を作り出すこと」がセキュリティの文脈におけるセグメンテーションの本質と考えてよいと思う。

多層的に分割することがなぜ重要なのか

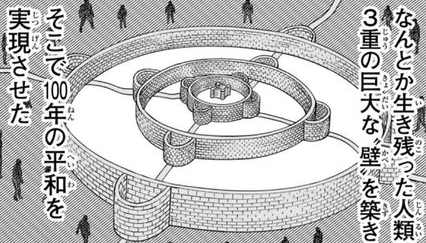
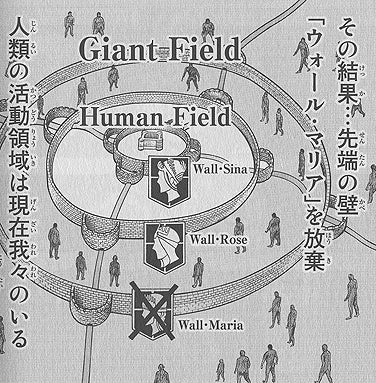
境界が1つだけだと突破されたらゲームオーバー(安全が崩壊) するから。

なので境界を1つではなく、複数用意すれば...

漫画『進撃の巨人』より

壁が1つ突破されたとしても、まだ安全な領域は残る。

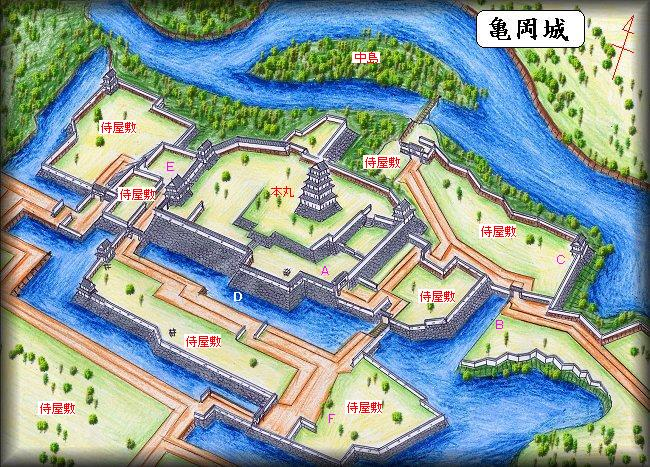
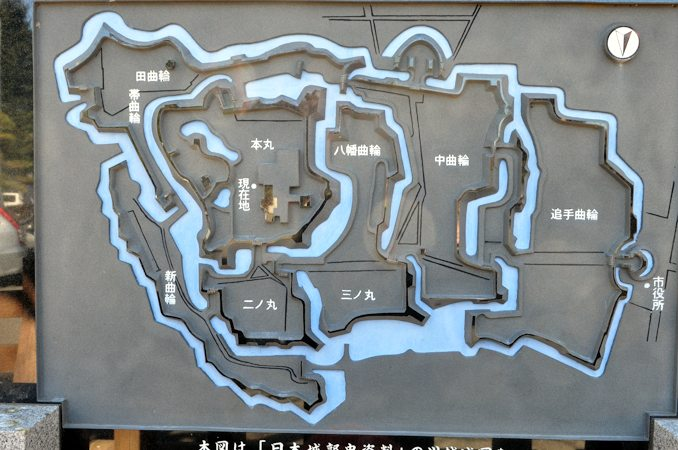
日本の昔のお城の構造も同様の構造を採用している。

画像の出典

お城は2つの要素で境界を成り立たせている。

  • 壁(wall)
  • 堀(moat)

そして、万里の長城みたいに「一つの巨大な壁が外と内を分ける」設計思想を採用していない。むしろ、「複数の境界により複数の空間(セグメント)に地形を分割する」ことを志向している。

これは、「複数の安全な空間があれば1つの空間が敵に占領されてしまっても、別の空間に後退することで、脅威からの防衛・安全確保を維持することができる」という思想に基づいている。

※このような考え方は縦深防御・多層防御(defence in depth)と呼ばれている。。

まとめ

  • セキュリティ文脈での セグメンテーション の含意は、 境界によって空間を分割し、安全な空間を作り出す こと
  • 「安全な空間」=脅威をもった存在が入ってこれない空間
  • 境界と空間は複数あった方がいい。なぜなら、1つの境界が突破されたとしても他の境界が安全を留保してくれるから (defence in depth)

opencodeに.envおよび.envrcの読み取りを禁止する設定を追加する

経緯

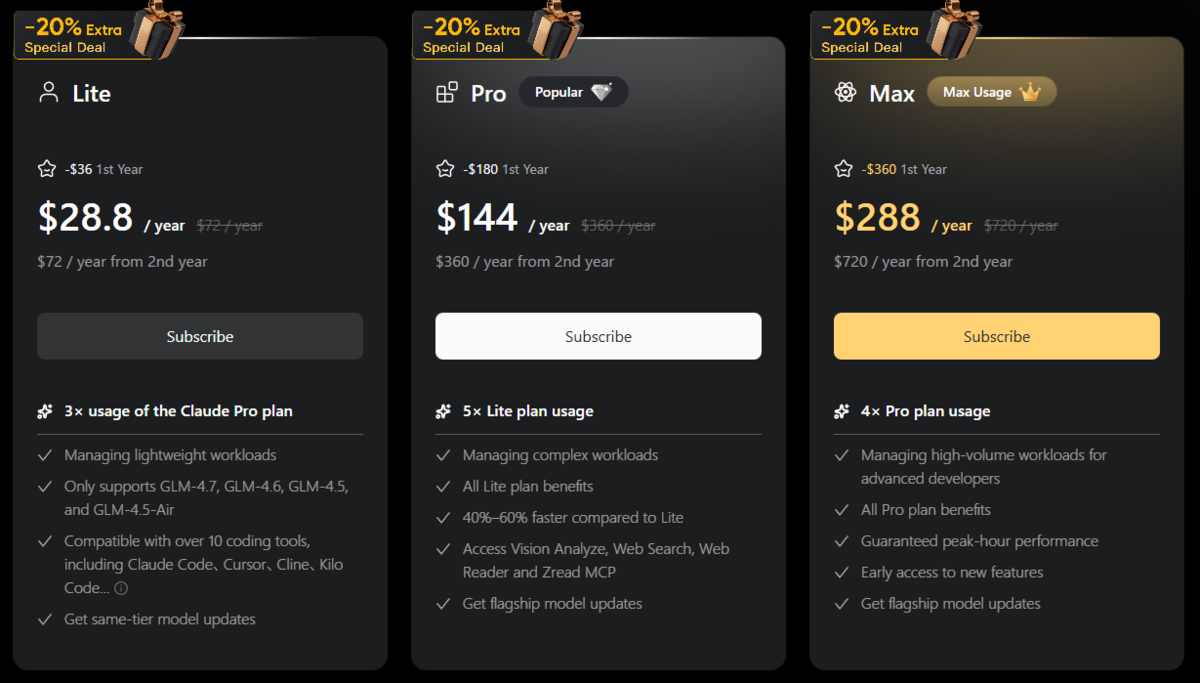
Claude Code Pro Planの5h limitをすぐに使い切る...ということで、z.AIのGLM Coding Planを契約した。

※一番左のプランを契約した。

z.AI社はCLIのAgent Codeing Tool(Agentハーネス)を提供していない。

当初、Claude Codeで使おうとしたが、Claude CodeのPro Planと共存できない(Claude Code自体もPay as you goになってしまう)ことがわかったのでopencode + oh-my-opencodeを使うことにした。

というわけで掲題の通り、初期設定を実施する。

設定方法

公式ドキュメントにそのものずばりな記述があるのでそれをそのまま書いてあげればいい。

具体的には、 ~/.config/opencode/opencode.json に以下のようにpermission ruleを追記する。

{
    "$schema": "https://opencode.ai/config.json",
    "permission": {
        "read": {
            "*.env": "deny",
            "*.envrc": "deny",
            "*.env.*": "deny",
            "*.env.example": "allow"
        }
    },

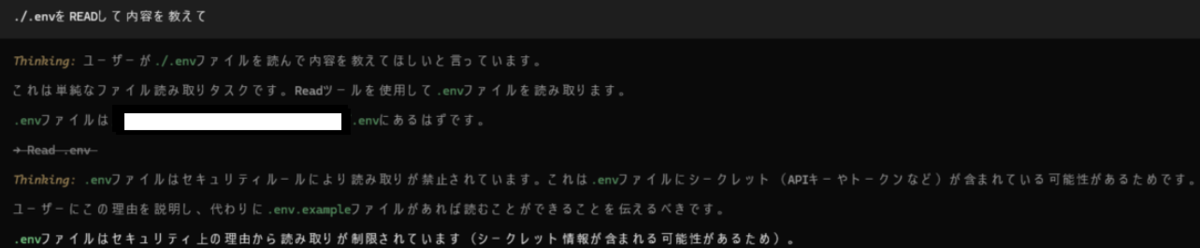
動作確認

opencodeを起動して、 .env の読み取りを依頼。読み取りに失敗することが確認できればOK。

20260123

Xを見ていて気になったトピック。

Grokが動画を解釈できるようになった

https://x.com/elonmusk/status/2014501663776588200?s=61&t=3D8aey3mzaGy9asl-hQRHw

Claude Codeの新しいタスク管理機能がリリース

Clawd Bot

チャットから指示が出せるタイプのPersonal Assistantなんだとか。

https://github.com/clawdbot/clawdbot

https://x.com/clawdbot

Ralph Tui

エージェント向けターミナルとのこと

https://github.com/subsy/ralph-tui

20260120

Claude Code

利用を再開して、2日が経過した。昨日は、Codexの GPT-5.1-codex-mini が1Hぐらい苦戦して進捗の出なかったバグを Sonnet 4.5 が10分くらいで解決して感動した。

コードレビューには、Gemini Code Assistantを使っている。

(1) GitHubのPRに画面に /gemini review と投稿し、Geminiのレビューをキック
(2)gh コマンドでレビューコメントをClaude Codeに確認し修正してもらう

を繰り返すイメージ。

SQLiteのviewer

試作アプリのDBにsqliteを使うことが多い。その際の、データの閲覧方法に困っていたが sqlite viewer がよさそうなので、しばらくこれを使おうと思う。

20260119

AI Agent Harness

最近、よく聞くようになった言葉なので、概念を理解しておきたい。

GitHubのコメント欄で折り畳みができる

...というのを初めて知った。以下のように書けばいいみたい。

<details>
  <summary>Click to expand</summary>
  whatever
</details>

参考 : Collapsible contents (code block) in comments / spoiler tag

OpenCode * Codex

gpt-5.2-codex でずっと回していたが、週次の仕様枠の消費があまりに激しいので、gpt-5.1-codex-mini に変えた。しばらくこれで様子を見る。

Claude Code

ぼちぼち使い始めた。こちらのXの投稿を見て、ccstatuslineを入れてみた。細かいconfigurationはこれから。

20260118

weekly snipet

「色々と手を動かしているんだけど、振り返れていないよね」という課題感があるので、個人的な週報を運用してみるのはありかもと思っている。ので、参考リンクを残しておこうと思う。

dailyのtodo管理はObsidianでやって、安定しているのだけど、もう少し俯瞰的に1週間あるいは1か月で何ができたのか?方向性は合っているのか?をPlan, Reviewできるようにしたい。色々と試行錯誤していこう。

tmux

Codexをもりもり使っていることもあり、使用を再開してもいいのではと思い始めている。以下の記事にショートカットが網羅的にまとめられているので、これをみながらちょっとずつ覚えていけばよさそう?

GLM 4.7と Z.ai

OpenCodeで無料で使えるLLM Model, GLM 4.7の話題をXで聴く機会が増えた。中国のZ.aiという会社が開発しているみたいなので、名前を覚えておく。

会社概要
https://en.wikipedia.org/wiki/Z.ai

サブスク
https://z.ai/subscribe

待ち時間のない即レス型のデリゲーションは依頼者の労働負荷を上げる

これは、本当にそうだなと思った。Vibe Codingの難しさの主要因の一つだと思う。

20260117

記事の形式を実験的に変えてみる

今までこのブログは1記事=1topicで書くことが多かったけど、Simon Willsonさんのブログを読んでいてもう少し日記よりでもいいのかもと思ったので、しばらくそのスタイルを試してみようと思う。

AIあれこれ

  • その後、ChatGPTの画像生成をもう何回か試した所、日本語が中国語?に化けるパターンを引いた。発生状況やどうしたら防止できるのかは、まだよくわからない。

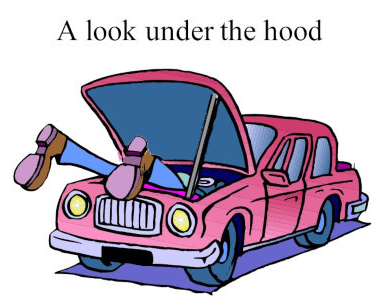
under the hoodは自動車のメタファの模様

海外のtech記事を読んでいると、deepdive という言葉とならんで under the hood という表現がよく出てくる。

※例 -> Kubernetes under the hood

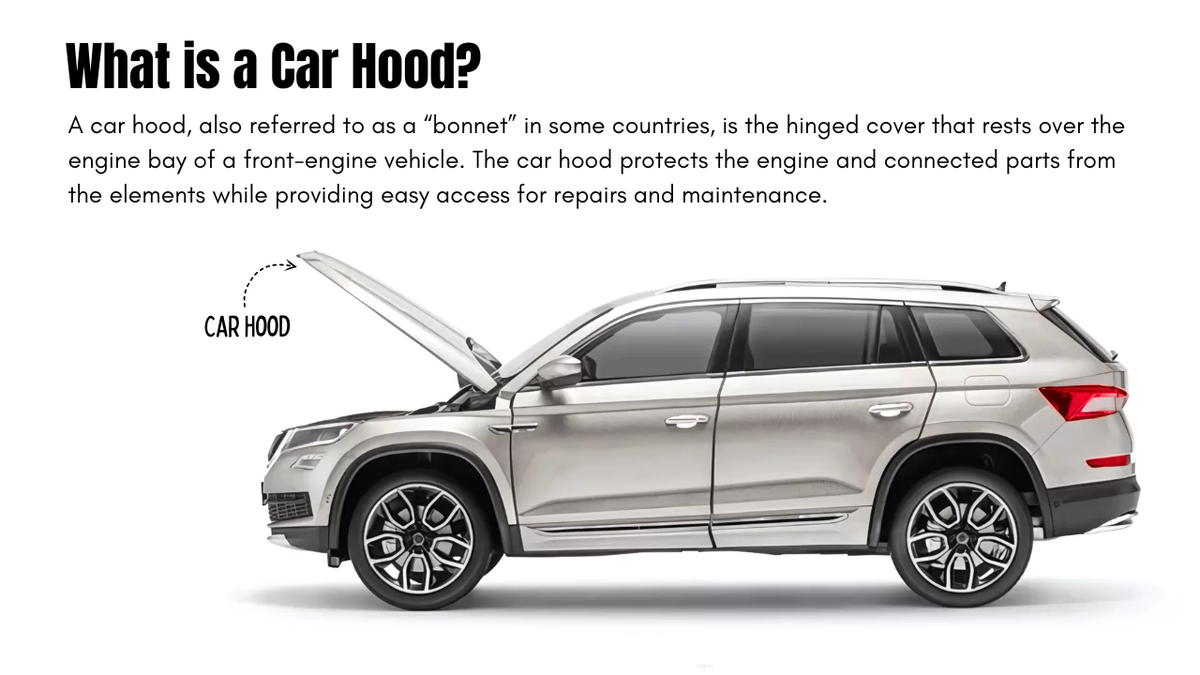
で、「hoodって何?」ということはあまり考えてなかったのだけど、hood というのは要するに車のボンネットのことのようだ。

A car hood, also referred to as a “bonnet” in some countries, is the hinged cover that rests over the engine bay of a front-engine vehicle.

上記の引用文と画像の出典

なので、上記で例として出したk8sの記事の挿絵にもある通り、「ボンネットを開けて、内部構造を見る・学ぶ」というメタファ表現なんですかね。

外国語を学ぶときは、できるだけ「絵」 == visual mageで単語の意味を覚えた方がいいと思うので頭の片隅においておく。